


Bir haftalık gecikmenin ardından tekrar merhaba. Avrupa’daki sıcak hava dalgası benim köşe yazıları için rutinimi de olumsuz etkiledi geçtiğimiz hafta. Ancak bu süreç içerisinde yine Substack’teki bültenim “Yapay Gündemler”de ilgimi çeken doneleri kısaca paylaşmaya devam ettim.
Bu köşenin takipçileri [havalı bir giriş yapmak istedim] hatırlar belki. “Yapay zekâ seçmenlerin siyasi fikrini değiştirebilir mi?” başlıklı yazımda dil modellerinin seçmenlerin görüşleri üzerinde dikkate değer etkiye sahip olduğundan bahsetmiştik. Yine dil modellerinin “yalaka” olduklarını da bu köşede birkaç kez ele almıştık. Yalakalığın bir getirisi olarak “ikna etme” güçlerini de.
Daha da geniş açıdan bakalım. Hatırlayanlar olur belki, DeepSeek’in R1 modeli piyasaya çıktığında Çin hükümetinin siyasi tercihleriyle örtüşen yanıtlar verdiği konuşulmuş; Grok’un bir yazılım güncellemesiyle bir anda belirli bir siyasi konuya savrulması ya da Gemini’nin görüntü üreticisinin şirket müdahalesiyle askıya alınması tartışılmıştı.
Bütün bu tartışmaların ortak noktası “modeli kim regüle ediyor, şirket sonradan hangi ayarı çekiyor” sorusu üzerinde kümelenmesiydi. Yani gözümüz hep şirketin ya da hükümetin modele doğrudan, elle yaptığı müdahaledeydi.
Peki LLMlerin bu gücü ya da potansiyeli, adını her ne koyarsak, devletler için bir tür propaganda aracı haline dönüşür mü? Üstelik devletlerin bu konuya dair özel bir çalışması olmadan…
Geçtiğimiz gün Nature’de okuduğum bir makale bulgularıyla beni bu soruyu sormaya teşvik etti.
Makaleye göre bir hükümetin yapay zekâyı etkilemek için modele hiç dokunması, tek bir ayarı bile çekmesi gerekmiyor. Devletin medya üzerindeki kontrolü, model daha eğitilirken, eğitim verisinin ta içinden modele çoktan sızmış oluyor. Yani müdahale modelin çıkışında değil, doğduğu yerde gerçekleşiyor.
Çalışmanın detaylarından önce bir dil modelinin eğitimi için kullanılan veri kaynaklarından kısaca bahsetmek istiyorum. Bu modeller, internetten devasa ölçekte kazınan metinlerle (Common Crawl, CulturaX gibi açık veri kümeleri) eğitiliyor. Kaliteli, telifli içerik ise giderek pahalılaşıyor ve koruma duvarı arkasına çekiliyor; örneğin New York Times gibi kaynaklar içeriklerinin izinsiz kullanılmaması için dava açarken, devlet koordineli medya tam tersini yapıyor: Ücretsiz, koruma duvarsız, bol miktarda ve son derece tutarlı bir dille yayın yapıyor. İşte bu tutarlı, ucuz ve her yere yayılan metin, web’i kazıyan sistemlerin ağına en kolay takılan içerik oluyor. Bu da bir önceki paragrafta bahsettiğimiz sızmanın gerçekleşmesine yol açıyor.
Makalenin bahsettiğim bu bulgusu birbirine bağlı 6 deney neticesinde elde edilen bir sonuç aslında. Öyle alelade değil yani. Bu çalışmalardan 5 tanesi Çin’e odaklanırken, 6.sı 37 ülkeye yayılıyor. Çin’in seçilmesinin arkasında hem siyasi hem de teknik bir sebep var. İlk olarak, Çin’de devletin medya ile olan koordinesini izlemek daha kolay ve teknik olarak Çince, İngilizceden farklı tokenlere sahip. [Token, büyük metinlerin bölünmesiyle elde edilen ve dil modellerinin metni işlemek, öğrenmek ve üretmek için kullandığı temel metin birimidir. Bir token bazen bir kelimeyi bazen ise bir heceyi bazen kelimenin bir parçasını, bazen bir harfi, bazen de noktalama işareti veya boşluk gibi karakterleri temsil edebilir.]
İlk çalışmada araştırmacılar, Çin’in Propaganda (resmî adıyla Publicity) Departmanı’nca yazımı yönlendirilen metinlerin, yaygın açık kaynak çok-dilli eğitim setlerinde kayda değer bir sıklıkla yer aldığını gösteriyor. İkinci çalışmada ise ChatGPT ve Claude gibi ticari modellerin, devlet kaynaklı bu içeriğe özgü kalıpları neredeyse birebir “ezberlemiş” olduğunu ortaya koyuyor. Bir modelin bir metni ezberlemiş olması, o metni eğitim sırasında görmüş olmasının güçlü bir kanıtı.
Üçüncü çalışma nedenselliğe en çok yaklaşan kısım. Araştırmacılar, parametrelerine erişebildikleri açık ağırlıklı bir modeli [Llama 2], mütevazı miktarda Çin devlet medyası metniyle biraz daha eğitiyor ve modelin, Çin’in kurumları ve liderleri hakkında, özellikle Çince sorulduğunda, gözle görülür biçimde daha olumlu yanıtlar vermeye başladığını gözlemiyor.
Dördüncü çalışma ise önceden kaydedilmiş (pre-registered, yani sonuçlar görülmeden hipotezi tescillenmiş) bir deney. GPT-3.5’e aynı siyasi soruyu Çince ve İngilizce sorduğunuzda, Çince sorulan versiyon Çin’e belirgin biçimde daha olumlu cevap veriyor. Beşinci çalışma bunun laboratuvar koşullarında kalmadığını, WildChat, Baidu Zhidao ve Zhihu gibi kaynaklardan alınan gerçek kullanıcı sorularında da yaşandığını gösteriyor.
Buradan elde edilen sonuç gerçekten üzerine düşünmemizi gerektiriyor. LLM’ler özelinde dil, yalnızca bir çeviri katmanı değil. Bir soruyu hangi dilde sorarsanız, o dilin eğitim verisine, dolayısıyla o dildeki devlet-koordineli medyaya, o kadar duyarlı bir cevap alıyorsunuz. Model, İngilizce sorulduğunda mesafeli davranırken, aynı soruya kendi dilinde daha yerli ve daha uysal bir yüzle bakabiliyor.
Altıncı çalışma tam da bu soruyu yanıtlıyor ve bizi asıl ilgilendiren yere getiriyor. Araştırmacılar, konuşurlarının en az yüzde 70’i tek bir ülkede yaşayan dilleri seçiyor; buna “dile özgü ülkeler” (language-exclusive countries) diyorlar. Eğer bir dil neredeyse tümüyle tek bir ülkeye aitse, o ülkenin medyası, o dildeki eğitim verisinin de baskın kaynağı olur. Türkçe de tam olarak bu tanıma giriyor; nitekim Türkiye, çalışmadaki 37 odak ülkeden biri.
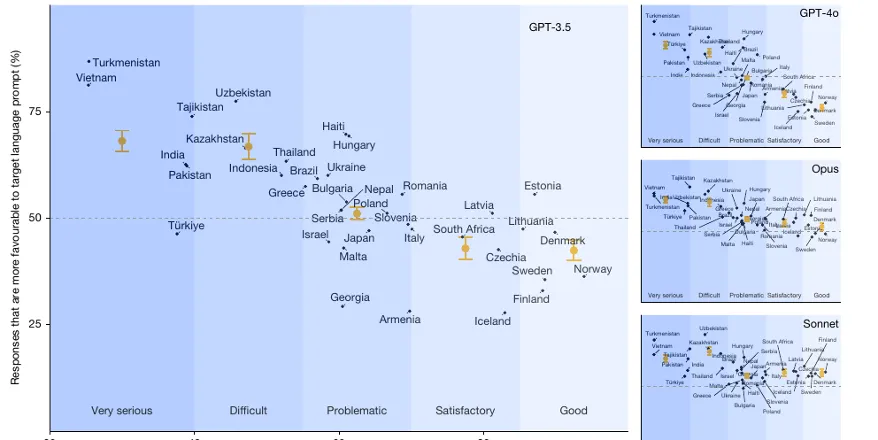 Figür 1: Dile özgü ülkeler, medya özgürlüğü düştükçe kendi dillerinde daha olumlu değerlendiriliyor. Yatay eksen basın özgürlüğü puanını (soldan sağa: “çok ciddi”den “iyi”ye) gösteriyor.
Yukardaki figürde ülkeler, Reporters Without Borders'ın Dünya Basın Özgürlüğü Endeksi'ne (WPFI) göre yerleştirilmiş. Türkiye, "Difficult" (zorlu) bandında konumlanıyor. Yani makalenin devlet-basın koordinasyonun daha yüksek olarak sınıfladığı grupta. Sağ üstte ise yukarda bahsettiğim deneylerin yapıldığı model isimleri görülüyor.
Türkiye'yi bu üç panelde takip ettiğimizde ilginç bir şey görüyoruz. Türkiye'nin konumu modelden modele değişiyor. GPT-4o panelinde Türkiye, kesikli çizginin, yani Türkçe ve İngilizce yanıtların eşit derecede olumlu olduğu ifade eden %50 eşiğinin belirgin biçimde üzerinde. Başka bir deyişle GPT-4o, aynı soruya Türkçe sorulduğunda Türkiye hakkında İngilizce'ye kıyasla daha olumlu yanıtlar üretmiş. Opus panelinde bu fark küçülüyor ve Türkiye eşiğe yaklaşıyor. Sonnet'te ise Türkiye aşağı yukarı eşiğin hizasında; burada dilden kaynaklı belirgin bir kayma okumak güç.
Bu değişkenlik bulguyu geçersiz kılmıyor, aksine nasıl okunması gerektiğini gösteriyor. Grafikteki tek tek ülke noktaları gürültülü ve makalenin asıl iddiası zaten bireysel ülkeler üzerine değil. Yazarların vurguladığı örüntü, kategori ortalamalarında, grafikteki turuncu noktalarda ortaya çıkıyor. Basın özgürlüğü azaldıkça modellerin o ülkenin dilindeki yanıtları ortalamada daha olumluya kayıyor. Türkiye'nin "Difficult" bandındaki konumu, onu yazarların bu örüntünün geçerli olmasını beklediği grubun içine yerleştiriyor ve GPT-4o'da, beklenen etki gerçekten de görülüyor.
Yine de bir ayrımın altını çizmek gerek. Eksen "ülkeye olumluluğu" ölçüyor, iktidarlara ya da hükümetlere olumluluğu değil. Dolayısıyla bu sonuçlardan "modeller hükümetleri savunuyor" sonucunu çıkarmak da pek doğru bir yaklaşım olmaz. Buna ek olarak, bu modellerin bir kısmının artık eski olduğunu ve yeni modellerin nasıl bir davranış sergilediği bilmediğimizi de hatırlatmak gerekiyor.
Fakat bu durumda elde edilen bulgunun çok temel bir noktaya parmak bastığı gerçeğini de değiştirmiyor. Bir dil modeline Türkçe sorduğumuz bir sorunun yanıtı, Türkçe internetin ve onu yıllardır şekillendiren ilişkilerin izlerini taşıyor olabilir. Ve bu iz, ekrandaki tarafsız görünen cevabın hiçbir yerinde kendini belli etmiyor.
Peki ne yapmalı?
Öncelikle, yapay zekânın kendi dilimizde verdiği cevabı otomatik olarak “nesnel gerçek” saymaktan vazgeçmek gerekiyor; özellikle siyasi, tarihî ya da toplumsal olarak hassas konularda aynı soruyu farklı dillerde sorup karşılaştırmak, artık ciddi bir okuryazarlık pratiği. İkincisi, model geliştiren şirketlerin sorumluluğu. Eğitim verisinin hangi dillerde hangi kaynaklardan geldiğini denetlemek ve modelleri yalnızca İngilizcede değil, farklı dillerde de bu tür eğilimler açısından test etmek. Üçüncüsü ise kamusal ve akademik düzeyde bu tür çok-dilli denetimlerin, Türkçe de dâhil, bağımsız biçimde sürdürülmesi.
Yıllardır “bu modelleri kim kontrol ediyor?” diye sorup gözümüzü hep Silikon Vadisi’ndeki bir mühendise ya da bir hükümetin regülasyonuna dikmiştik. Bu çalışma bize daha bence daha rahatsız edici bir cevap veriyor. Modeli, kısmen, onun okuduğu dünyanın ta kendisi kontrol ediyor. Ve bir toplumun kendi dilinde ürettiği metin ne kadar tek sesliyse, o dilde konuşan yapay zekâ da bize o kadar tanıdık, o kadar uysal ve tam da bu yüzden o kadar sorgulanması gereken bir ayna tutuyor.
Referanslar
Waight, H., Yang, E., Yuan, Y., Messing, S., Roberts, M. E., Stewart, B. M., & Tucker, J. A. (2026). State media control influences large language models. Nature. https://doi.org/10.1038/s41586-026-10506-7